A IA responde em segundos. Você não precisa.
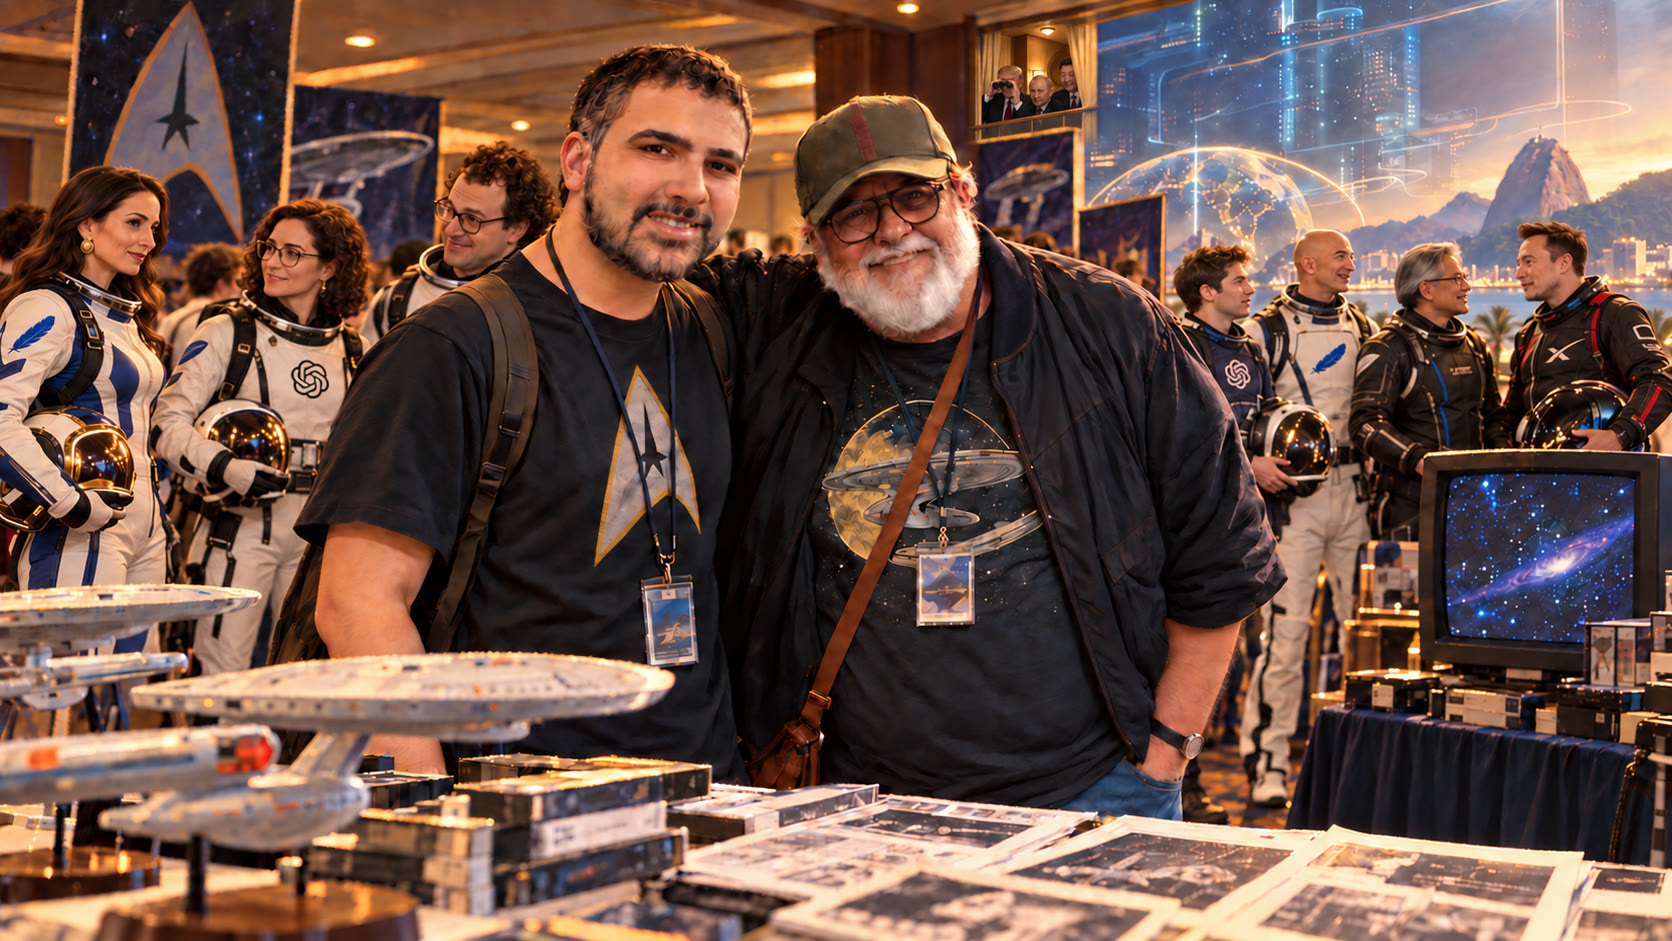
Capa gerada por IA: meu pai e eu em um evento imaginário de fãs de ficção científica no Rio. A cena é fictícia; seu papel é abrir a memória real entre pai e filho a partir da qual começa este capítulo da minha história humano–máquina.
Space, the final frontier
These are the voyages of the Starship Enterprise
Its five year mission
To explore strange new worlds
To seek out new life
And new civilizations
To boldly go where no man has gone before— Star Trek: The Original Series, opening narration (StarTrek.com).
Todo Trekker reconhece o convite. Antes de saber o que era uma GPU, eu era uma criança que assistia a Star Trek ao lado do meu pai. Aprendi a imaginar o futuro com ele. Hoje vivo por dentro da computação acelerada, perguntando o que máquinas que respondem em segundos estão mudando em mim.
É assim que estou entendendo o momento atual da IA generativa — a era dos modelos generativos, especialmente os large language models (LLMs) com os quais trabalho. Não é uma teoria sobre toda IA, nem sobre como todas as pessoas deveriam viver. É o que eu sinto usando essas máquinas agora, dentro de uma mudança grande o bastante para atravessar também a jornada do nosso life span: envelhecer, aprender e gastar um tempo que continua finito enquanto a velocidade em volta aumenta.
Eu acho essa mudança individualmente fascinante. Aprender linguagem humano–máquina no tempo de LLMs, frontier models e Generative AI é um desafio cognitivo próprio. Muitos LLMs e frontier models são construídos sobre Transformer architectures e attention mechanisms; isso não vale para toda Generative AI. Justamente por isso, o avanço que responde em segundos está me ensinando a não responder na mesma velocidade.
Engenharia de linguagem com máquinas cibernéticas
O nome que encontrei para o que estou fazendo é engenharia de linguagem com máquinas cibernéticas.
Não estou propondo uma nova disciplina. Estou tentando dar um nome preciso a um ciclo que consigo observar. Eu formulo alguma coisa em linguagem. Um LLM responde. A resposta altera o que percebo, o que considero importante e até a pergunta que eu acreditava estar fazendo. Então formulo outra vez.
Linguagem → máquina → atenção alterada → linguagem novamente.
Chamo isso de recursivo porque a saída volta como parte da próxima entrada. Se nada em mim mudou e eu apenas pedi outra versão, não foi pensamento recursivo. Foi repetição com eletricidade.
Essa recursão acorda uma lembrança antiga. Quando cursei Sistemas de Informação à noite na PUC-Rio, depois de um estágio e de uma jornada de trabalho exigentes, eu muitas vezes chegava exausto à primeira aula; às vezes dormia durante ela. Análise de algoritmos — dynamic programming, recursão, complexidade — foi a única disciplina que tranquei, com medo de reprovar.
Voltei numa segunda tentativa, com olhos mais descansados, e aquelas ideias ficaram em mim. Hoje, pensando recursivamente com IA, reencontro-as fora da lista de exercícios: uma resposta vira entrada, o custo de cada ramo importa, e nem todo caminho merece ser computado. Isso é nostalgia, não equivalência. Uma mente e um algoritmo não são o mesmo objeto.
Essa mesma interface também me faz viver entre idiomas humanos. Uma formulação começa em português, encontra outra borda em inglês e volta diferente — não porque tradução seja automática ou perfeita, mas porque a linguagem passou a ser um espaço de trabalho acessível dos dois lados. Engenharia de linguagem, para mim, é tanto conversar com o modelo quanto perceber o que uma ideia ganha e perde ao atravessar um idioma.
O modelo já chega até mim moldado por feedback humano. Técnicas como RLHF (reinforcement learning from human feedback) ajustam o modelo durante o treinamento a partir de demonstrações e preferências humanas. O meu ciclo cotidiano não é RLHF: corrigir um prompt não altera os pesos do modelo. O que ele altera, imediatamente, é a próxima formulação — e a pessoa que a formula.
No artigo sobre os meus três loops, escrevi sobre a interpretação que tirei de Co-Intelligence, de Ethan Mollick: tratar a IA como alguém trabalhando ao meu lado tornou visível que o viés humano podia aparecer nos dois lados da mesa. Agora essa leitura avançou um passo para dentro. A questão deixou de ser apenas como desenho agentes que discordam. Passou a ser como desenho a minha própria atenção enquanto converso com eles.
A leitura de The Coming Wave, de Mustafa Suleyman com Michael Bhaskar me ajudou a enxergar a mesma mudança em outra escala: como uma onda tecnológica, não como uma ferramenta isolada. Essa é a minha interpretação do livro, não uma formulação que atribuo a ele.
Essa é a parte que não cabe num prompt. O modelo participa da recursão. Quem precisa perceber a recursão sou eu.
O próprio formato deste artigo faz parte do argumento. Ele foi fortemente inspirado por Deus, vaidade e morte: conversa de Karnal com uma IA, de Leandro Karnal: uma reflexão sobre colaboração humano–máquina apresentada como colaboração humano–máquina. A experiência, a tese e a responsabilidade pelo que está aqui são minhas. A máquina ajudou a interrogá-las, verificar as referências e encontrar a forma. Ela não viveu nada disso por mim, nem funciona como oráculo.
A próxima resposta também é um estímulo
Às vezes percebo o ciclo antes de conseguir dar nome a ele. Faço uma pergunta à IA. A resposta chega em segundos. Uma frase abre uma hipótese; a hipótese pede um teste; o teste abre outra janela. Quando noto, não estou mais respondendo a uma pergunta. Estou sendo conduzido pela promessa da próxima resposta.
É por isso que uso a palavra dopamina com cuidado: como precisão, não como protagonista da história. A pesquisa clássica sobre reward-prediction error relaciona sinais de dopamina à diferença entre recompensa esperada e observada durante o aprendizado. Um experimento em seres humanos ligou a dopaminergic modulation desses erros à forma como resultados atualizam decisões futuras. Isso me ajuda a dar nome ao motivo pelo qual um resultado inesperado pode puxar a atenção. Não diagnostica todo encontro com IA.
Reward learning é uma capacidade biológica importante, mas isso não transforma cérebro e algoritmo no mesmo objeto. Biological reward learning, algorithmic reinforcement learning e RLHF se tocam no feedback que muda o que vem depois. Não se confundem.
O que consigo afirmar é menor e pessoal. Reconheço busca por novidade, antecipação de recompensa, curiosidade, validação social, vigilância e urgência de responder se intensificando juntas. O verdadeiro problema de gestão de tempo não está na minha agenda. Está no segundo entre uma resposta e a próxima pergunta: tempo suficiente para perceber respiração, postura, empolgação, irritação e cansaço antes que o ciclo transforme tudo em outro prompt.
Habitar o intervalo é tornar-me presente o bastante para notar mais da experiência, não menos. O ciclo pode estar ensinando. Também pode apenas estar me mantendo dentro dele.
Presença não reduz a experiência. Ela aumenta o quanto dela eu consigo sentir.
Fazer o tempo esperar
Quando digo que quero reagir de forma estoica, não estou tentando ficar impassível. “Viva as emoções, não fuja delas” é uma fronteira importante para mim.
A pausa não elimina a emoção; ela impede que a emoção e a reação se tornem o mesmo evento.
No Enchiridion, Epicteto volta algumas vezes ao mesmo movimento: primeiro aparece uma impressão; depois vem a possibilidade de examiná-la. No capítulo 20, ele diz que ganhar tempo e respiro torna mais fácil não ser arrastado pela aparência. No 34, diante de um prazer prometido, pede que a coisa espere um pouco.
É uma tecnologia antiga para um problema com uma interface nova.
Quando uma resposta de LLM chega e parece resolver tudo, eu posso deixá-la esperar. Quando me irrita, posso viver a irritação sem imediatamente devolvê-la para a máquina na forma de um novo comando. Quando me entusiasma, posso sentir o entusiasmo inteiro antes de transformá-lo em mais cinco tarefas.
Na dúvida, nunca duvide dos gregos. Eles sabem das coisas.
O que me interessa nessa ironia é bastante sério.
Fazer o tempo parar não é interromper o mundo. É separar impressão, emoção e escolha por tempo suficiente para que a escolha volte a ser minha.
O corpo precisa reconhecer o ambiente
Também comecei a tratar os lugares onde trabalho como parte dessa linguagem.
Estou aprendendo IA diante de mais telas do que consigo olhar ao mesmo tempo.
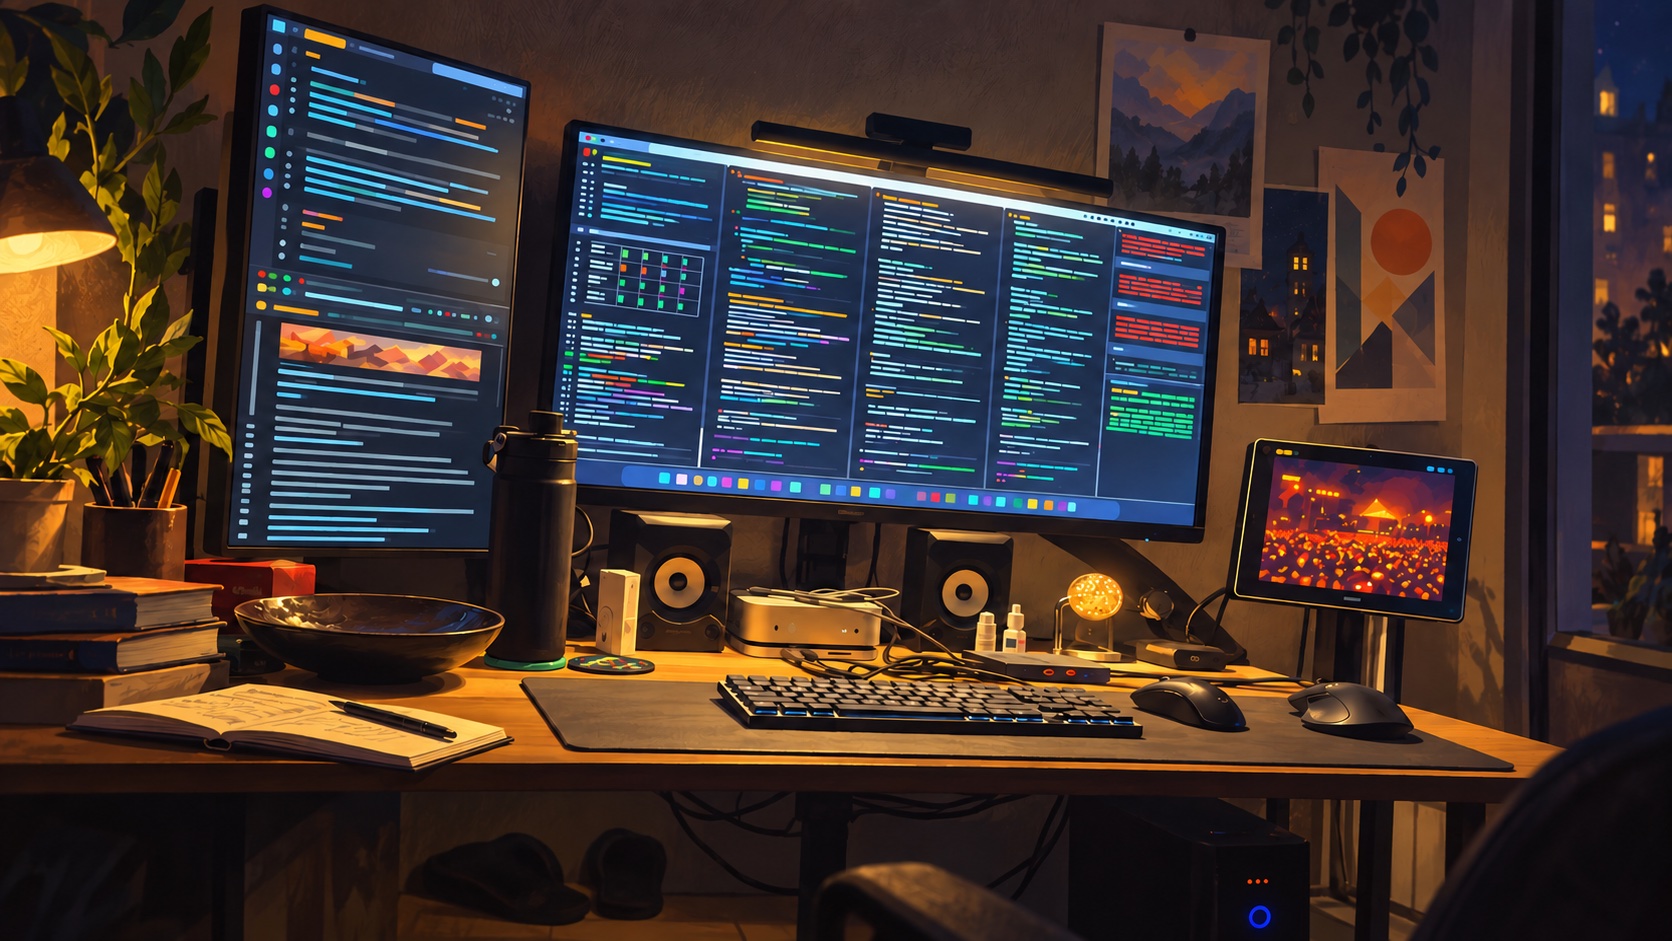
Ponte visual do argumento gerada por IA a partir de uma fotografia do meu ambiente real de trabalho. O arranjo físico vem desse ambiente; o conteúdo das telas foi abstraído para proteger contexto privado. Ela expressa a densidade sensorial de aprender diante de mais telas do que consigo acompanhar ao mesmo tempo.
Isso é RLHF — reinforcement learning from human feedback? Não exatamente. Isso é ser humano.
Não é uma cena excepcional. É justamente a repetição: uma resposta aparece, abre três caminhos, desloca a minha atenção e torna muito fácil pedir a próxima. As palavras voltam mais rápido do que o meu corpo consegue perceber o que aconteceu com elas.
Eu passo por contextos diferentes nas mesmas telas, às vezes dentro da mesma hora. Quando todos eles têm a mesma disposição física, a passagem fica invisível. O trabalho muda; o corpo continua recebendo o mesmo quadro.
Arranjos visualmente distintos me ajudam a marcar a transição. Mudo a posição das telas, dos objetos, do que fica aberto e do que sai do campo de visão. Não afirmo que essa arquitetura melhora a cognição de qualquer pessoa. Em mim, ela dá forma física a uma mudança que antes existia apenas dentro da cabeça.
A descoberta de hoje é que preciso levar a mesma distinção para o harness. Eu atravesso projetos pessoais, ambientes internos, contextos de clientes e harnesses diferentes; os princípios éticos que protegem a minha responsabilidade individual precisam atravessar essas fronteiras comigo. Os princípios que protegem sua responsabilidade precisam viajar com você; o contexto local só diz onde você está.
Meu baseline pessoal carrega os princípios éticos que não posso delegar. Privacy by harness perimeter é um deles. Cada workspace ancora o papel — pessoal, interno ou cliente — e acrescenta suas restrições locais. A política governada de empregador ou cliente fica dentro daquele perímetro; não retorna ao meu baseline pessoal. O que viaja é o princípio. Identidade e propriedade de outra esfera, não.
Isso torna a experiência mais sensorial, não menos. O ambiente deixa de ser fundo e vira um sinal. A tela continua acesa, mas eu consigo perceber de qual trabalho ela está me chamando — e, algumas vezes, perceber que não quero atender ainda.
Essa é uma jornada em contato intenso comigo mesmo. Por fora, os sinais são sutis: um objeto que muda de lugar, uma janela que fecha, um minuto antes da próxima pergunta. Por dentro, a sucessão de telas, respostas e ambientes atravessa o corpo inteiro.
A inteligência que eu quero possuir
Garry Tan chamou seu keynote mais recente de Own Your Intelligence. A descrição publicada pelo próprio Y Combinator fala de agentes rodando em infraestrutura própria, acumulando conhecimento ao longo do tempo, e da diferença entre possuir essa inteligência e alugá-la.
No artigo anterior, eu tinha conectado outro talk dele ao cérebro de uma empresa: modelos são alugados; o que uma organização aprende pode ser seu. Este novo keynote empurra a pergunta para a pessoa.
Na noite passada, eu estava lendo Nexus, de Yuval Noah Harari. O livro atravessa a história pelas redes e pelos fluxos de informação. A leitura que ficou comigo não é uma citação de Harari: talvez a IA esteja se tornando uma nova alavanca da idade do saber e da informação — e eu esteja tentando aprender a tocá-la sem entregar a ela o meu tempo inteiro.
Eu vivi essa escala chegando em camadas. A internet conectou redes; o hipertexto deu relações aos documentos antes de o HTTP oferecer uma forma prática de movê-los pela Web. A banda larga mudou o ritmo, o mobile mudou o lugar do acesso, a cloud mudou a forma de provisionar computação, e as GPUs ampliaram o que conseguíamos executar em paralelo. Não são uma invenção só, nem uma cadeia causal bem-comportada. Na minha vida, formam uma sucessão de interfaces e escala — e a IA generativa é a camada mais recente a se tornar cotidiana enquanto ainda estou aprendendo o que as anteriores fizeram comigo.
Essa alavanca tem uma genealogia material estranha e bonita. A própria história publicada pela NVIDIA começa com gráficos 3D para games e multimídia; em 2006, CUDA abriu a capacidade de processamento paralelo das GPUs para computação de uso geral. Durante a pandemia, a cripto ampliou a procura por esse hardware, sem ter criado a tecnologia: no relatório fiscal de 2022, a empresa atribuiu o crescimento de gaming a uma combinação que incluía games, trabalho remoto e mineração, e registrou US$ 550 milhões em processadores específicos para mineração. Demanda não é origem técnica. Foi outra onda empurrando a mesma base.
Antes de saber o que era uma GPU, eu era uma criança millennial que assistia a Star Trek atentamente com meu pai. Hoje, computação acelerada, máquinas com que converso, voos espaciais e ambição interplanetária fazem com que eu sinta que vivo uma era real de Star Trek. A Blue Origin levou William Shatner ao espaço; a SpaceX declara que quer tornar a vida multiplanetária. Para a criança que eu fui, isso explica a admiração afetiva: os fundadores são sinais culturais ao redor, não heróis.
E aqui está o punch que amarrou a imagem para mim: eu vivo na era da programação por linguagem humana–máquina alinhada, potencializada por energia elétrica e rodando sobre computação paralela cuja linhagem comercial foi desenvolvida, em essência, por gráficos e videogames. “Era NVIDIA” é o meu atalho histórico, não a afirmação de que uma empresa inventou sozinha a computação paralela, nem de que todo LLM dependa de um único fornecedor. Programar por linguagem humana também não elimina código: significa que formulação, contexto e correção passaram a orientar uma parte real do trabalho.
Jensen Huang chama essa virada de accelerated computing: em 2024, disse que ela havia chegado a um ponto de inflexão; em 2026, a NVIDIA descreveu a IA como infraestrutura essencial de uma nova era industrial. Essa é a visão da empresa sobre o momento, não uma história neutra dele. Na história mais ampla, Huang é um dos seus principais arquitetos materiais. Na minha leitura pessoal, ele é o arquiteto deste momento.
É isso que chamo de “presente NVIDIA”: a infraestrutura que aprendeu a desenhar mundos agora participa das máquinas linguísticas com que reorganizo o meu. Essa é, para mim, uma das imagens centrais do momento atual da IA generativa.
É nesse ponto que outra figura de Star Trek volta para mim: Data. A história oficial do personagem mostra um androide recorrendo à pintura, à música, à poesia e ao teatro para investigar uma humanidade que ele conseguia observar, mas não experimentar como nós.
Será que hoje eu sou o Data? A pergunta chega invertida. Data era uma máquina usando arte, relações e experiência para entender o que significava ser humano. Eu sou um humano usando máquinas, linguagem e arte para entender a minha própria humanidade.
Agent Harness Engineering, engenharia de prompt, tokenmaxxing, engenharia de linguagem: esses nomes são tentativas de tocar partes da prática que estou vivendo, não de transformá-la numa nova doutrina. O que reconheço por baixo deles é uma ontologia pessoal da relação humano–máquina — corpo, atenção, linguagem, tempo, memória, ambiente, feedback, trabalho, infância e futuro. O harness não inventa nenhuma dessas coisas. Ele as torna observáveis e versionáveis enquanto eu construo, para que eu possa voltar e reconhecer não apenas o que fiz, mas quem estava me tornando ao fazê-lo.
A extensão é minha, não dele: possuir a minha inteligência começa antes da infraestrutura. Começa nas condições em que permito que ela mude. A memória que conservo importa. Os procedimentos que escrevo importam. E também importam o ritmo em que peço a próxima resposta, o ambiente em que a leio e o intervalo que preservo antes de reagir.
É o aprendizado que a fase atual da minha vida profissional está me cobrando agora. Eu o ofereço como um presente, não como um método: uma pausa que talvez você consiga experimentar no seu próprio contexto.
Dois experimentos para levar com você: antes do próximo prompt, nomeie o que a última resposta mudou na sua atenção; e dê a dois contextos de trabalho uma diferença física visível, só para observar se a passagem entre eles deixa de ser invisível.
Isso não é um sistema de produtividade nem uma promessa contra burnout. “Sem burnout” é o limite que eu desejo para a minha própria vida, não um resultado clínico que eu possa garantir. O que consigo praticar é menor: viver as emoções sem fugir delas, reconhecer o que hoje foi possível e acreditar que fiz o meu melhor até esse limite.
Um dia de cada vez. Estoicamente, se der. Humano, de qualquer jeito.
Esta é uma iniciativa pessoal, independente e sustentada por mim. Meu compromisso é continuar aprendendo em público com as pessoas e as máquinas desta era, e devolver o que eu descobrir enquanto conseguir sustentar as ferramentas e a infraestrutura que tornam esse trabalho possível. Quero aproveitar o presente da era que vivemos hoje sem me ausentar dele.
Isso é o que está acontecendo hoje, em escala. Não sei se vocês perceberam. Me digam o que pensam sobre isso.
Grande abraço, e até a próxima.
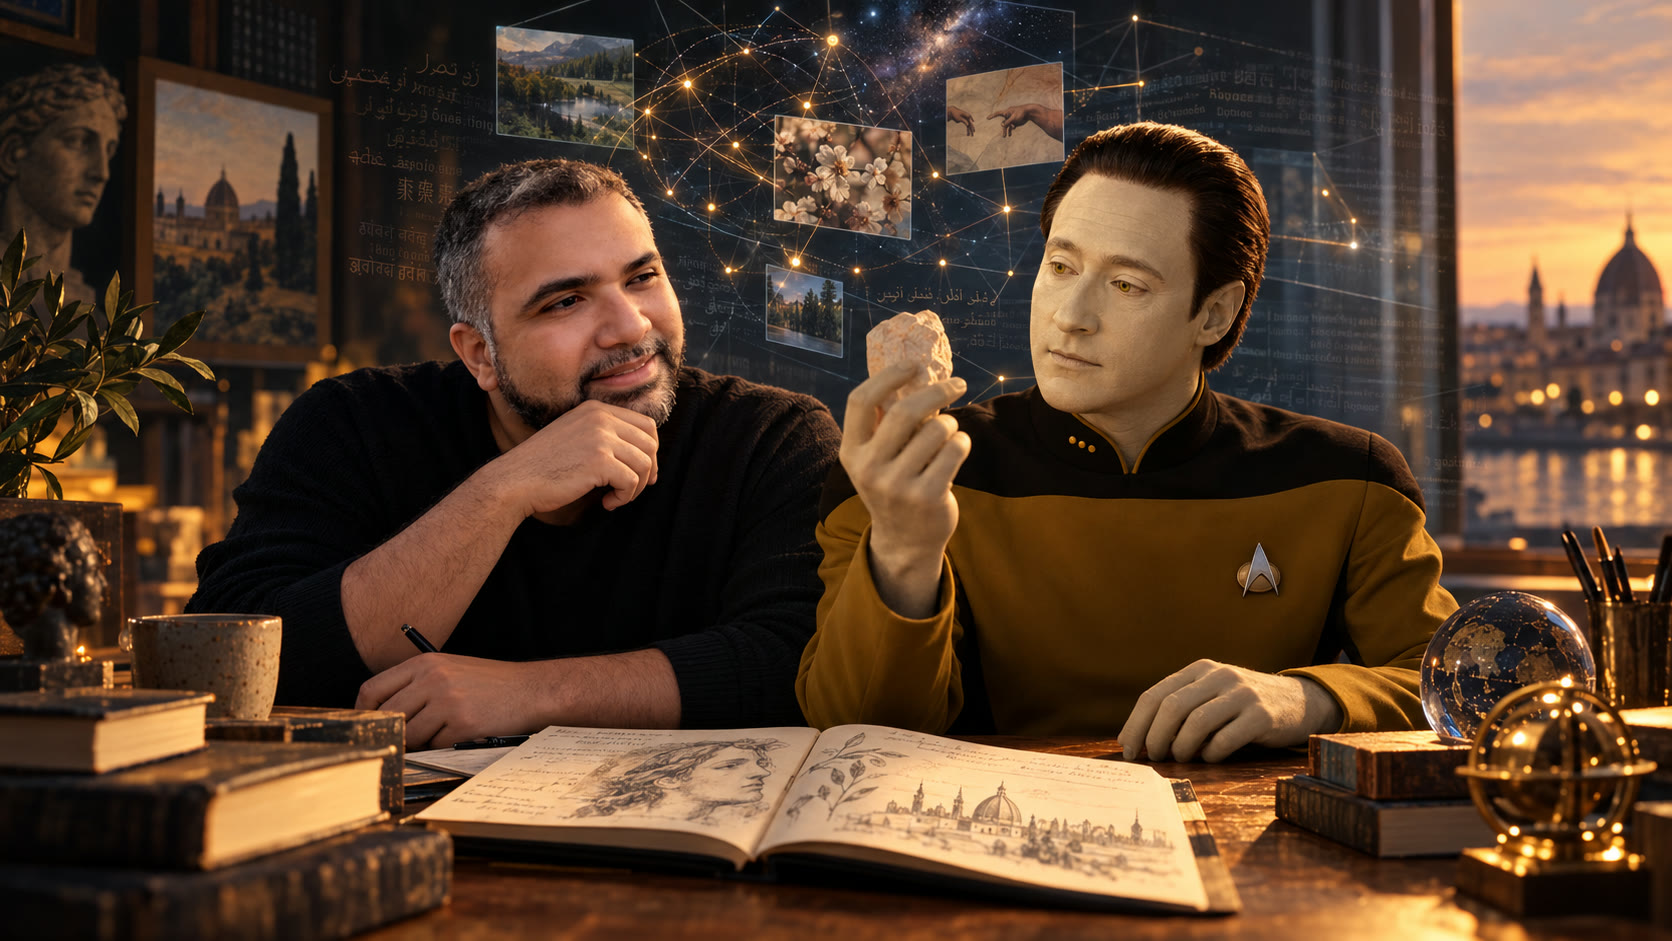
Rodapé reflexivo gerado por IA: Data é o espelho invertido. O androide usava arte e relações para investigar a humanidade; eu uso máquinas, linguagem e arte para observar a minha. A imagem devolve a pergunta viva deste capítulo sem respondê-la por mim.
“Isso é AGI — ou apenas parece? Vai do tempo nos dizer.”
THIS IS WHAT I THOUGHT · tadeumendonca.io